核心业务服务器 /home 陷入完全不可读写,dmesg 滚动打印 XFS I/O Error,元数据严重不一致(空闲块统计偏差 51 亿)。经历 umount target is busy 死锁(kill + Lazy Umount 破解)→ xfs_repair -n 只读诊断(B+树重叠 + 日志脏数据)→ 突破 Log 保护启用 -L 强制修复 → 七阶段全量重构(Phase 1~7)→ 恢复挂载验证 + 硬件隐患复盘,附完整操作命令与防范准则。
本案例目录
CHART 01 // 抢救时间线 · 七阶段
repair timeline · phase by phaseCHART 02 // 元数据损坏指标
corruption indicatorsLinux XFS 文件系统元数据损坏(I/O Error)全流程抢救实录
服务器:
yygyl-szny03(节点名已隐去)· 排查日期:2026-09-06 说明:文中主机名等已脱敏,操作命令与输出均保留原文。
一、 故障背景与现象发现
在企业级生产环境中,基于 RHEL/CentOS 构建的高性能 Linux 服务器通常默认使用 XFS 文件系统。XFS 拥有出色的多线程并发写入能力和对海量小文件的高效管理能力,但由于其高度依赖分配组(Allocation Group, AG)与 B+Tree 元数据索引结构,一旦发生非正常掉电、底层物理存储介质坏块或 I/O 阻塞,就可能引发极为棘手的元数据不一致(Metadata Corruption)。
某日值班期间,监控系统突发警报:一台核心业务服务器(节点名:yygyl-szny03)的 /home 目录陷入完全不可读写状态,业务进程相继抛出「Input/output error」。进入系统后,dmesg 内核缓冲区频繁滚动打印以下红字错误:
[Sun Sep 6 19:17:59 2026] XFS (dm-2): Please unmount the filesystem and rectify the problem(s)
此时,内核已经检测到 dm-2 逻辑卷上的 XFS 元数据结构遭受破坏,为防止脏数据进一步污染持久化介质,触发了防御性只读/脱机保护机制。然而,真正的运维抢救挑战才刚刚开始。
二、 遭遇死锁与卸载难题:破解 Target is busy
在执行修复前,XFS 要求必须先卸载文件系统。但当我们常规执行 umount /home 时,系统直接抛出了经典的运维噩梦——「umount: /home: target is busy」。即使尝试追加 -f 强制卸载参数,依旧无法卸载。
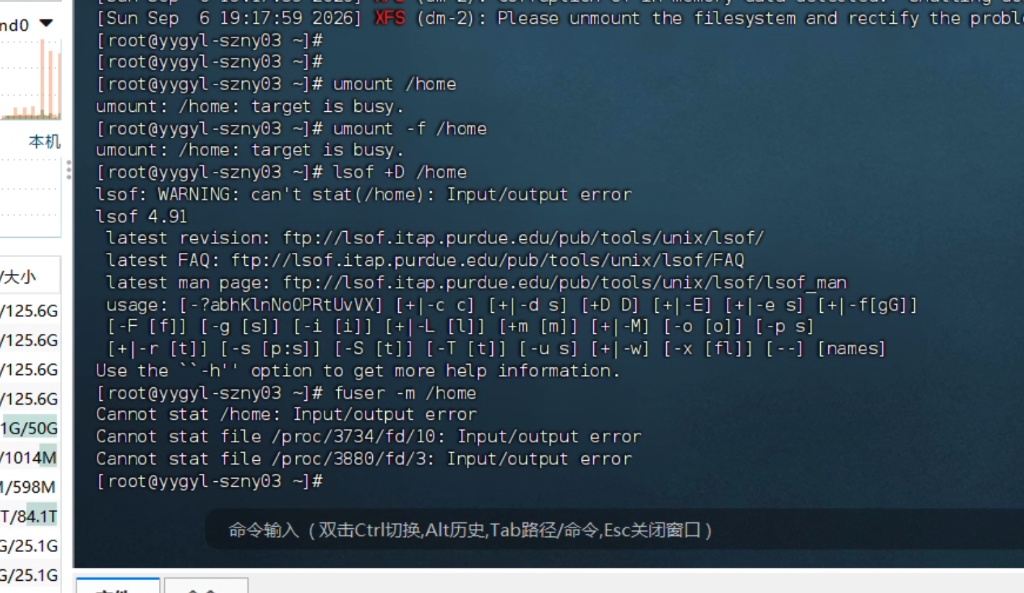
从图 1 可以清晰看到问题根源:
- 执行
lsof +D /home时,由于底层元数据损坏,lsof 无法执行stat()遍历目录树,报「lsof: WARNING: can't stat(/home): Input/output error」; - 使用
fuser -m /home检测,虽然同样遭遇 stat 报错,但成功揪出了占用该挂载点的两个僵死进程描述符:/proc/3734/fd/10与/proc/3880/fd/3。
针对这种进程句柄挂死且文件系统已不可用的极端情况,标准处理流程如下:
# 1. 强行终止持有损坏文件句柄的进程
kill -9 3734 3880
# 或批量清理所有挂载点关联进程
fuser -ck /home

# 2. 若依然提示 busy,采用 Lazy Umount(延迟/懒卸载)从当前目录树剥离
umount -l /home

# 3. 确认卸载状态
df -h | grep /home
💡 运维关键技能点:为何使用 Lazy Umount?
umount -l(Lazy Unmount)是处理挂载点忙的终极武器。它会立即将该文件系统从系统命名空间目录树中分离隐藏,新进程无法再访问它;同时等待所有现有占用该挂载点的内核活动全部结束后自动释放底层引用,从而彻底打破卸载死锁。
三、 初步诊断与元数据侦测:xfs_repair -n 只读探查
卸载完成后,绝不能盲目直接执行写操作修复。生产排错的第一准则是「先诊断、知全貌」。我们通过 lvdisplay 或 ls -l /dev/mapper 确认了 dm-2 对应的 LVM 路径为 /dev/rhel/home,随后执行带 -n 参数的只读检测:
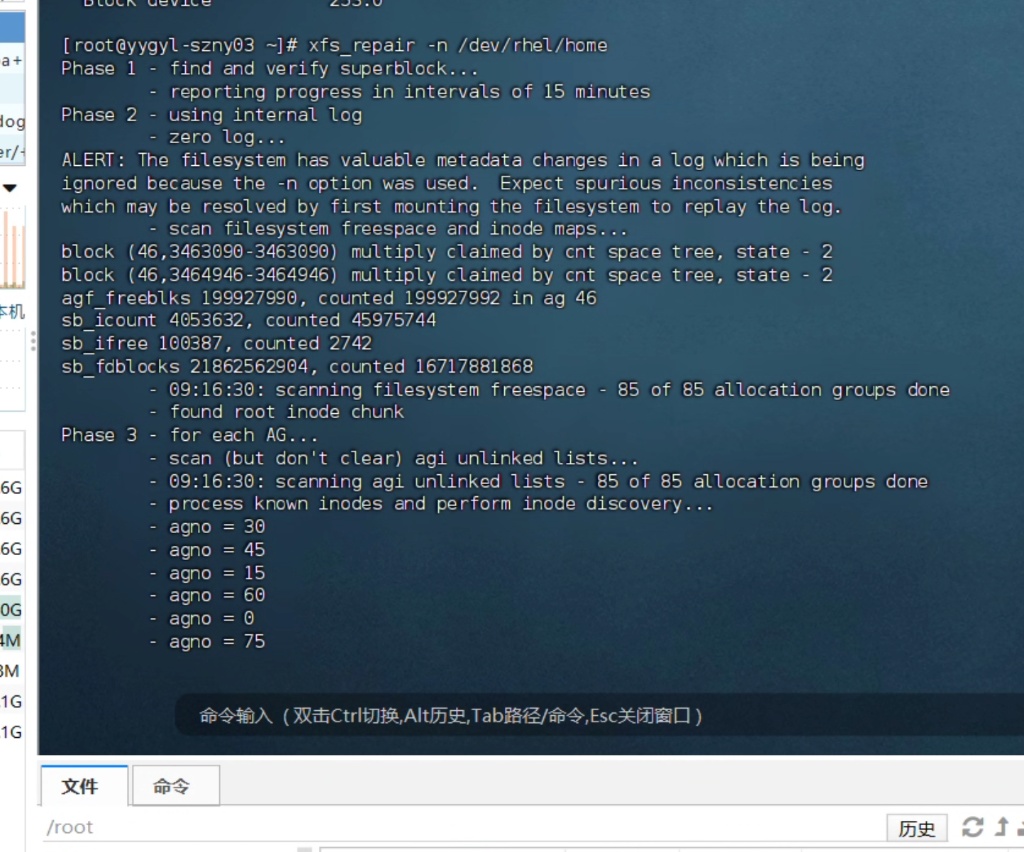
xfs_repair -n /dev/rhel/home
通过图 2 的诊断输出,我们可以捕捉到几个致命的异常指标:
- ALERT 告警:The filesystem has valuable metadata changes in a log which is being ignored...(日志区存在尚未落盘的元数据变更);
- 空间树重叠:block (46,3463090-3463090) multiply claimed by cnt space tree(块被重复声明使用,B+树索引错乱);
- 统计严重失真:超级块记录的空闲块数(sb_fdblocks 21,862,562,904)与实际遍历统计数(counted 16,717,881,868)相差达 51 亿个块!这印证了元数据已严重受损。
四、 核心决断:突破 Log 保护与启用 -L 强制修复
在确认问题后,我们首先尝试标准修复指令 xfs_repair /dev/rhel/home。但系统立即拒绝执行并弹出 ERROR 拦截:
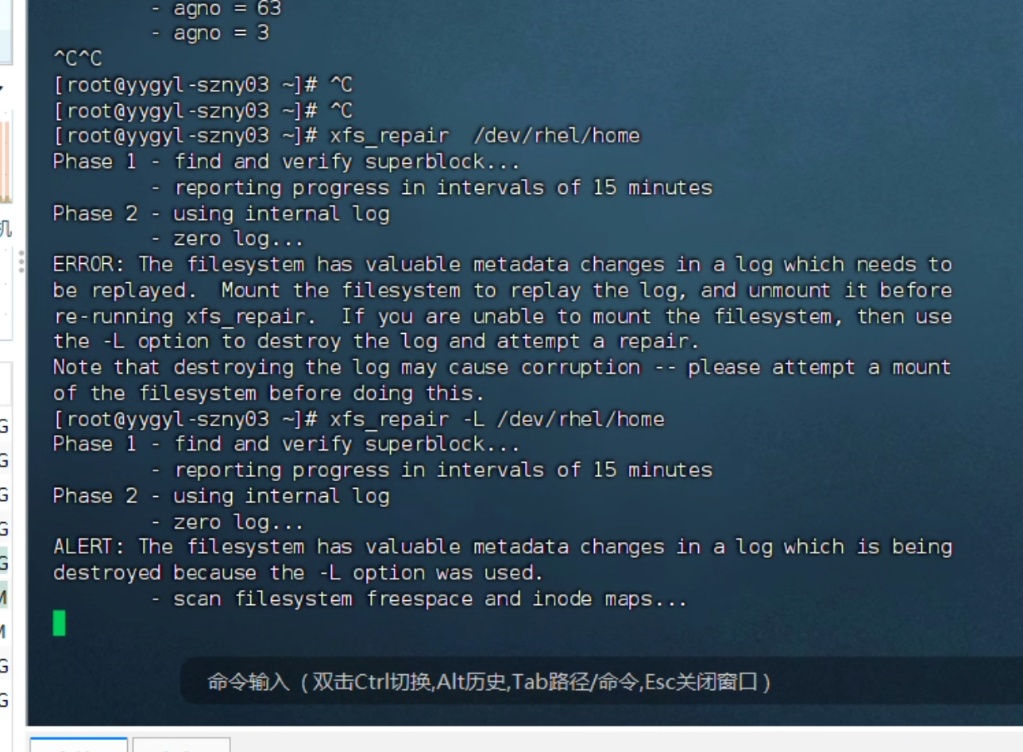
ERROR: The filesystem has valuable metadata changes in a log which needs to be replayed.
Mount the filesystem to replay the log, and unmount it before re-running xfs_repair.
If you are unable to mount the filesystem, then use the -L option to destroy the log and attempt a repair.
【技术决策权衡】:
常规情况下,XFS 希望管理员重新挂载文件系统以重放日志(Replay Log),将未提交的事务同步到数据区。然而在当前环境下,正是由于底层发生 I/O 错误导致元数据错乱,系统在挂载时直接触发内核 Panic 或抛出 I/O Error 拒绝挂载。陷入死循环时,-L(Zero Log / Destroy Log)是唯一的生路。
使用 -L 的后果:清空当前未落盘的日志事务,可能会丢失系统崩溃前最后几秒钟写入的数据,但它能解除日志重放死锁,允许工具全力重构超级块、分配组 B+Tree 和 Inode 映射表,保全已有 TB 级别的历史存量数据!
五、 全程执行与深度技术拆解:XFS 修复的七大阶段
执行 xfs_repair -L /dev/rhel/home 之后,运维人员必须保持耐心,切忌因耗时漫长而强制 Ctrl+C 中断,否则会导致元数据处于更严重的半截修复状态。整个过程严格按 XFS 架构划分为 7 个阶段:
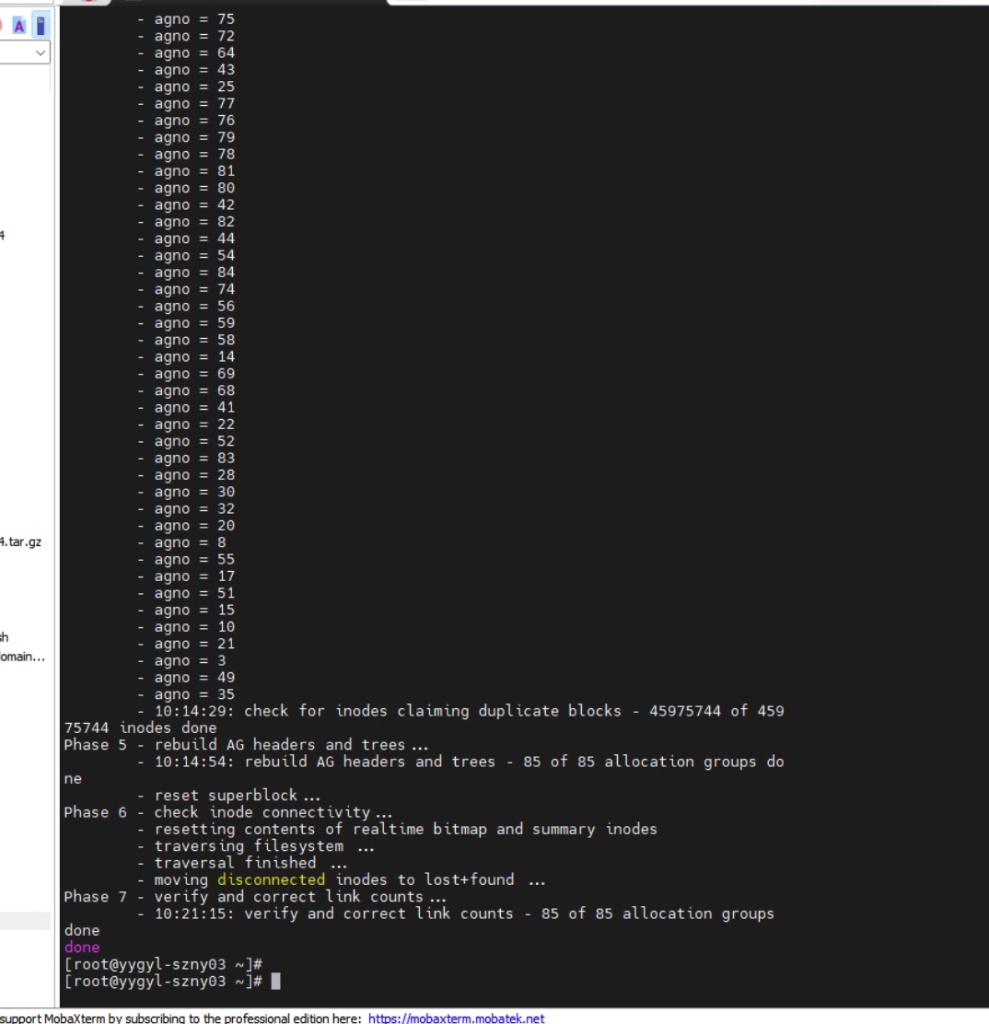
| 阶段(Phase) | 核心任务与运作机制 | 运维关注重点 |
|---|---|---|
| Phase 1 | 查找并验证 Primary Superblock,若损坏则从备份 AG 查找副超级块 | 确认基本扇区与块大小 |
| Phase 2 | 分析并清空内部日志(Zero Log),扫描空闲空间与 Inode 映射 | 耗时较长,显示进度间隔 |
| Phase 3 | 扫描各个分配组(AG)的 agi unlinked 列表,发现并标记已知 Inode | 并发检查各 AG 状态 |
| Phase 4 | 检查 Inode 冲突块,清理重复声明(Duplicate Blocks)的非法分配 | 消除块冲突(空间一致性) |
| Phase 5 | 重建分配组头部(AG Headers)及空闲空间 B+Tree,重置超级块 | 重构核心文件系统索引 |
| Phase 6 | 检查 Inode 连通性,将失去目录父子关系的孤立 Inode 积入 lost+found | 数据挽救,关键孤岛恢复 |
| Phase 7 | 校验并修正所有文件的链接计数(Link Counts),完成收尾 | 输出 done 标志着修复成功 |
六、 恢复挂载与数据善后验证
当终端最终输出两个连续的 done 并返回 root 提示符后,标志着 XFS 文件系统的底层逻辑结构已重获新生。此时应立即进行三步验证:
# 1. 重新挂载逻辑卷
mount /dev/rhel/home /home
# 或者按照 /etc/fstab 全局挂载
mount -a

# 2. 检查挂载状态与空间容量
df -h /home

# 3. 检查孤立脱钩文件
ls -la /home/lost+found
在本次修复中,df -h 顺利显示 /home 容量正常恢复,且无只读保护告警。对于 lost+found 目录中的脱钩文件(若存在形如 #123456 的无名文件),可通过 file <文件名> 命令识别其真实数据类型(如 gzip 压缩包、SQL 转储或文本),并根据业务内容进行原名还原。
七、 深度复盘:防范硬件隐患与生产级运维规范
文件系统修复成功并不代表排错彻底终结!因为最初触发的「Input/output error」往往意味着底层硬件存储存在严重隐患。必须立即排查底层硬件与链路状态:
# 1. 检索底层磁盘是否有读写坏块与超时
dmesg -T | grep -E -i "error|sector|ata|scsi|I/O|abort" | tail -n 50

# 2. 检查物理磁盘 S.M.A.R.T 健康状态
smartctl -H /dev/sda
smartctl -A /dev/sda | grep -E "Reallocated|Pending|Uncorrectable"

# 3. 若为阵列卡(如 LSI / MegaRAID),检查物理盘及电池状态
megacli -PDList -aALL | grep -E "Firmware state|Media Error|Other Error"
storcli /c0 /eall /sall show
针对企业高可用架构,提出以下三条防范准则:
- 黄金备份法则(3-2-1 原则):永远不要寄希望于文件系统自愈,数据库与用户核心家目录必须具备周期性异地冷备与实时增量快照;
- 存储健康主动巡检:将
smartctl与 RAID 控制器报错指标集成到 Prometheus + Node Exporter 监控平台,坏道预警先于系统崩溃处理; - 规范化挂载参数:对于关键业务 XFS 分区,建议评估挂载参数(如 nobarrier、allocsize 等),同时确保服务器配齐冗余双电源(UPS)及 RAID 卡写缓存后备电池(BBU),防止掉电导致日志撕裂。