GPU 服务器(8× Tesla V100-SXM2-32GB)CPU 占用异常:大量 [acpi_pad/*] 内核线程(ACPI Processor Aggregator Driver)各占 ~75% CPU 持续 220+ 分钟,[nv_queue](NVIDIA 驱动线程)36~70% CPU,同时 nvidia-smi 刷新严重卡顿、GPU 使用率分布不均,且存在二三十个 run_class_finetuning.py 训练进程疑似重复启动。定位为 acpi_pad 内核线程异常 + GPU 训练负载叠加 导致整机 CPU 调度繁忙;处置:卸载 acpi_pad 验证并 blacklist 持久化、停掉冗余训练组、内核/BIOS 排查。
本案例目录
CHART 01 // 故障信号 · 观察顺序
signals in order observedCHART 02 // 定位路径 · 由现象到根因
diagnosis path服务器:
[GPU 服务器](主机名已隐去)· 故障日期:2026-08-31 现象:大量[acpi_pad/*]内核线程长期占满 CPU、[nv_queue]高负载、nvidia-smi刷新缓慢 脱敏说明:主机名、用户名、服务器 IP 等敏感信息均已隐去,截图中敏感区域已打码。
环境与系统信息
| 项目 | 信息 |
|---|---|
| 服务器 | [GPU 服务器](主机名已隐去) |
| GPU | 8× NVIDIA Tesla V100-SXM2-32GB |
| NVIDIA 驱动 | 560.35.05 · CUDA 12.6 |
| 内核线程 | acpi_pad(ACPI Processor Aggregator Driver) |
| 主要负载 | 分布式训练(run_class_finetuning.py,DDP --local-rank) |
| 故障时间 | 2026-08-31(CPU 异常已持续约 215 分钟) |
故障现象
运维侧反馈 GPU 服务器 CPU 使用率异常、命令响应缓慢,top / nvidia-smi 刷新卡顿数秒甚至十几秒。初步观察到的信号:
- 大量
[acpi_pad/N]内核线程各占 ~75% CPU:PID 13xxxx 段,TIME+已累计 220+ 分钟,几十个线程同时处于 RUNNING 状态(见 图2); [nv_queue](NVIDIA 驱动内核线程)36~70% CPU:PID 17938/17960/17982/17988 等,长时间高负载(见 图1);containerd一度 115% CPU、dockerd9%+(见 图1);load average峰值 122,逐步回落到 76 → 36:压力主要出现在过去一刻钟之前,正在回落;nvidia-smi严重卡顿:刷新一次数秒到十几秒,期间%CPU仍有约 54.5% idle;- GPU 使用率分布不均:GPU 3 = 100%、GPU 6 = 33%,其余 0%;
- 二三十个
run_class_finetuning.py --local-rank=NPython 训练进程:每个 CPU 100%+、RES ~2.2G,疑似多组分布式训练被重复启动。
关键截图
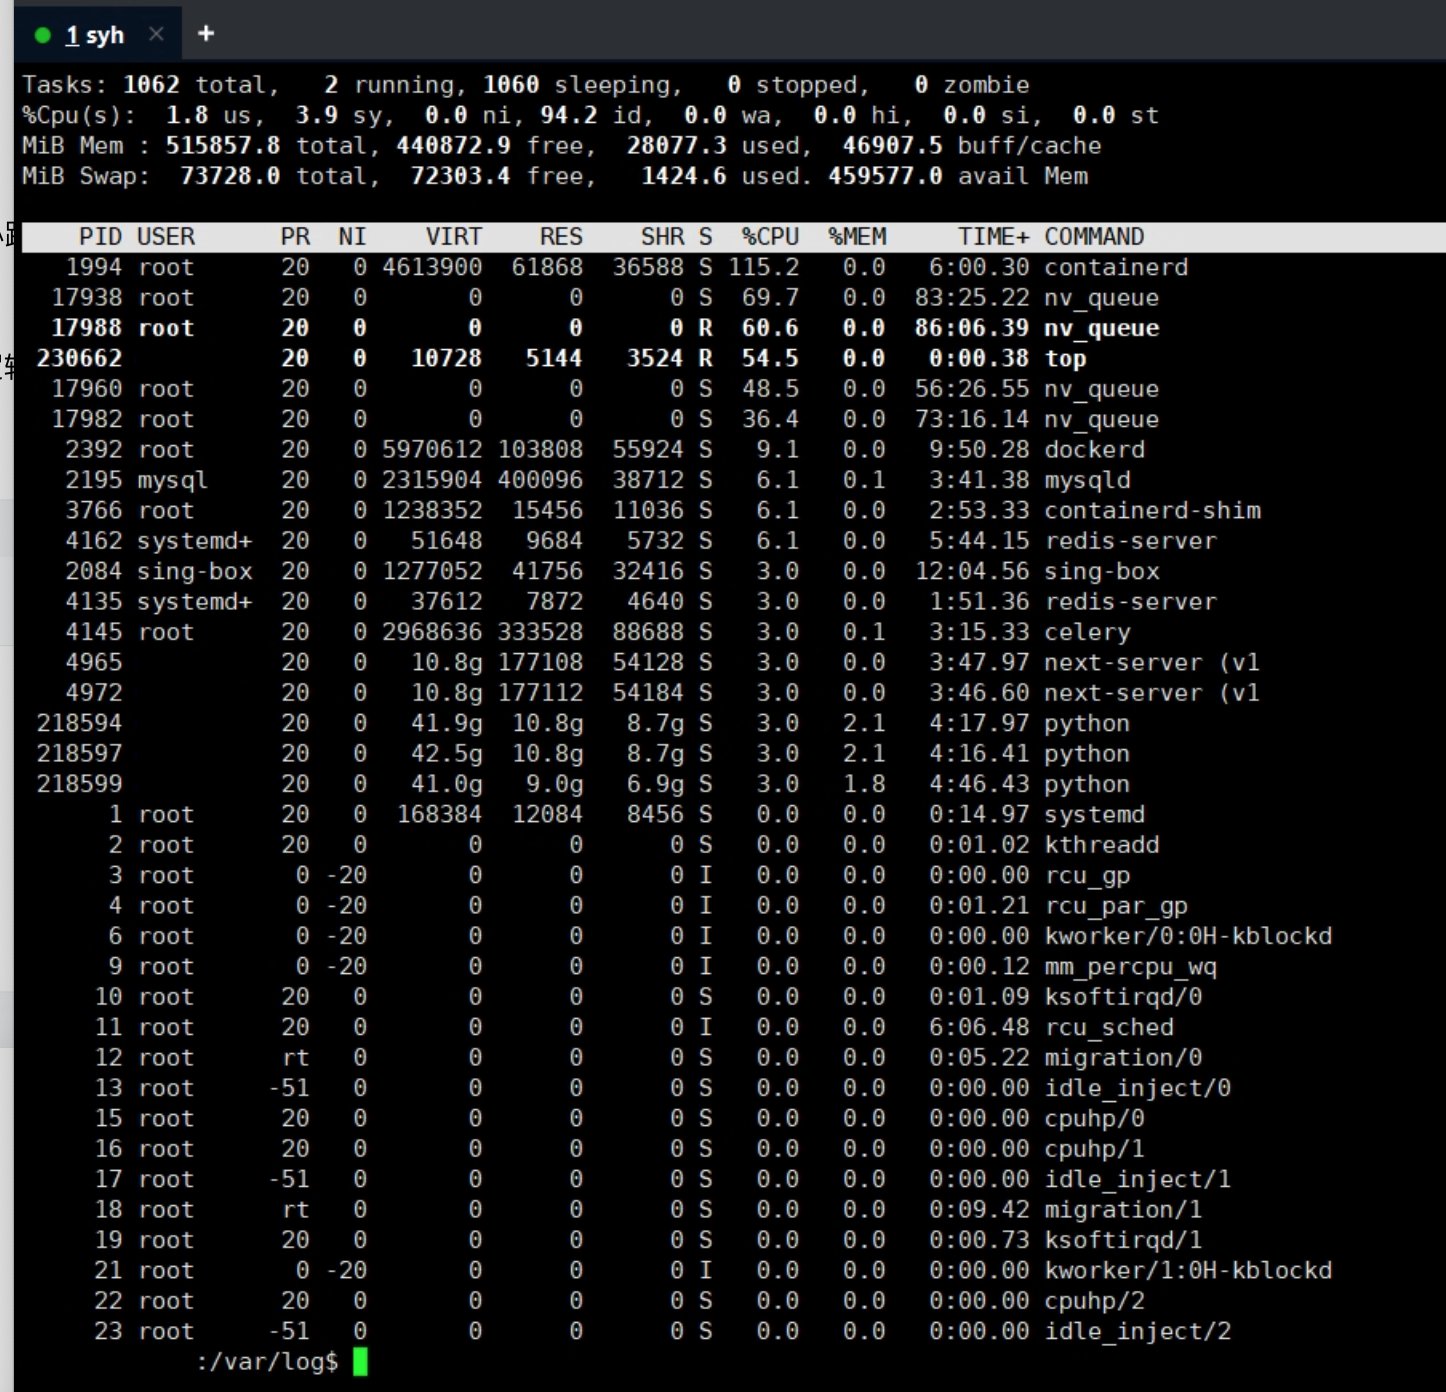
图1:
top进程列表。[nv_queue]为 NVIDIA 驱动内核线程,与 GPU 训练负载相关;USER 列与提示行的用户名、主机名已打码。
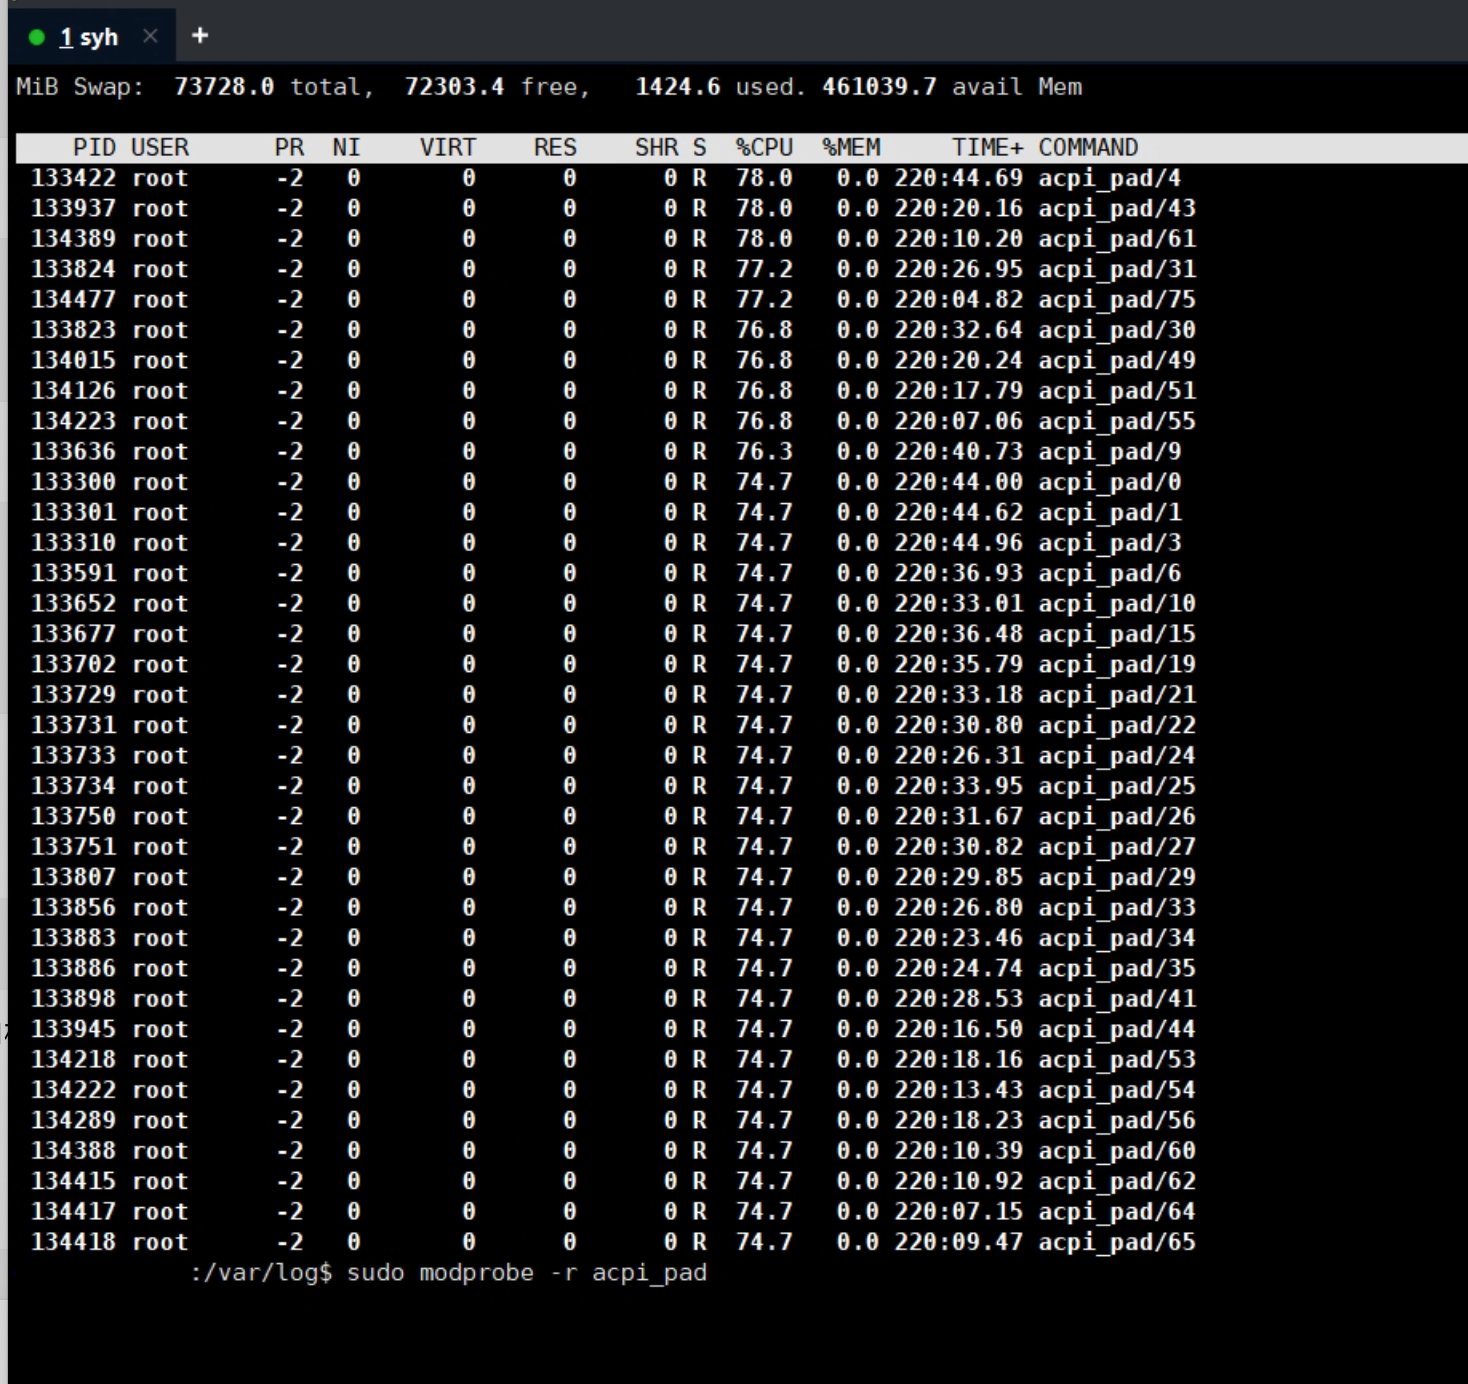
图2:
top按 CPU 排序后,满屏[acpi_pad/*]内核线程(PID 13xxxx),各占 ~74~78% CPU,TIME+累计 220+ 分钟;底部正执行sudo modprobe -r acpi_pad卸载验证。提示行主机名已打码。
排查过程
① 识别异常主体:方括号 = 内核线程
[acpi_pad/23]、[acpi_pad/25] 这类带方括号的进程是内核线程,不是普通用户进程:
ps -eLo pid,tid,psr,pcpu,comm | grep acpi_pad
lsmod | grep acpi_pad
acpi_pad 是 ACPI Processor Aggregator Driver(处理器聚合器驱动),用于服务器 CPU 电源管理 / 功耗控制。正常情况不应几十个线程长期占用 CPU。
② 检查内核与 ACPI 相关报错
dmesg -T | grep -Ei 'acpi|acpi_pad|processor aggregator' | tail -100
同时确认虚拟化 / 物理机属性与发行版,区分是 Linux 内核 bug、BIOS/ACPI 问题还是虚拟化平台因素:
uname -a
cat /etc/os-release
systemd-detect-virt
lscpu | head -30
③ 卸载验证(先定位,再下结论)
对不依赖 ACPI PAD 做特殊电源管理的服务器,可尝试卸载驱动并观察:
modprobe -r acpi_pad
top
如果 [acpi_pad/N] 全部消失、CPU 恢复正常,即坐实驱动异常。若提示 modprobe: FATAL: Module acpi_pad is in use,不能 kill -9 这些 PID——它们是内核线程,处理方式与普通进程不同,需要先排查占用原因。
④ 交叉验证 nvidia-smi 卡顿
先测查询本身慢不慢:
time nvidia-smi > /dev/null
再查 GPU 占用进程与驱动层异常:
nvidia-smi pmon -c 1
fuser -v /dev/nvidia3
dmesg -T | grep -iE 'NVRM|Xid|nvidia' | tail -100
注意 NVRM: Xid 31 / 43 / 79、GPU has fallen off the bus 等关键字。本例未发现 Xid,可排除 NVIDIA 驱动单独卡死。
⑤ 普查训练进程
pgrep -af run_class_finetuning.py | wc -l
pgrep -af run_class_finetuning.py
结论是同时存在多组分布式训练(--local-rank=0/1/2/... 多组并存),而非单组训练被拆分到多卡——存在重复启动嫌疑。
根因定位
这是多信号叠加导致的整机 CPU 调度繁忙,而非单一故障:
| 信号 | 性质 | 说明 |
|---|---|---|
[acpi_pad/*] 大量内核线程 ~75% CPU |
异常 | ACPI Processor Aggregator 驱动 / 内核 / BIOS 层问题,正常不应长期占用 |
[nv_queue] 36~70% CPU |
驱动活跃 | NVIDIA 驱动内核线程,随 GPU 工作负载升高 |
run_class_finetuning.py 二三十个 |
疑似重复启动 | 多组 DDP 训练并存,CPU/GPU 分配不当 |
nvidia-smi 卡顿 |
连带结果 | 查询被整机繁忙的 CPU 调度拖慢,而非驱动查询本身死锁 |
load average 122→76→36 |
佐证 | 压力峰值已过、正在回落;截图时刻 CPU 仍有约 94% idle |
关键判断:nvidia-smi 慢的根因在 CPU 调度层面——几十个内核线程 + 大量训练进程把 CPU 抢占殆尽,SSH、nvidia-smi、磁盘 I/O、驱动线程全部响应迟缓;其次是 GPU 负载分布不当(二三十个进程挤占少数 GPU:GPU 3 100% / GPU 6 33% / 其余 0%)。
处置流程
第一步:卸载 acpi_pad 验证(若服务器不依赖)
modprobe -r acpi_pad
top          # 观察 [acpi_pad/N] 是否消失、CPU 是否回落
第二步:若已确认,blacklist 持久化
echo "blacklist acpi_pad" > /etc/modprobe.d/blacklist-acpi-pad.conf
按发行版重建 initramfs(否则下次启动模块可能重新加载):
# RHEL / CentOS / Rocky / Alma
dracut -f

# Ubuntu / Debian
update-initramfs -u
先别急着 blacklist——先确认是 Linux 内核 bug、BIOS/ACPI 问题还是虚拟化平台导致,再决定是屏蔽驱动还是升级内核 / BIOS / 固件。
第三步:收敛训练任务
- 核对是否同一任务被重复启动多组:
pgrep -af run_class_finetuning.py; - 停掉冗余训练组,逐组观察
top与nvidia-smi是否恢复秒开; - 后续启动用
nohup+ 独立日志 + PID 文件,避免重复拉起;多卡训练显式指定CUDA_VISIBLE_DEVICES并用numactl绑核。
第四步:排除驱动 / 硬件层
dmesg -T | grep -iE 'NVRM|Xid|nvidia',确认无 Xid 错误;nvidia-smi -q核对 GPU 与驱动健康度。
预防措施
- 训练任务生命周期管理:启动写 PID 文件 / 唯一日志名,二次拉起前先检查;必要时加锁防重入;
- 显式 GPU 分配:多卡训练用
CUDA_VISIBLE_DEVICES/numactl绑定 NUMA,避免进程争抢少数 GPU 与 CPU; - 内核线程异常告警:对
acpi_pad等内核线程的 CPU 占用与运行时长建立阈值告警(正常应接近 0); - 升级前置验证:内核 / ACPI / BIOS / 固件升级前在测试环境验证电源管理行为;
- 命令卡顿分级排查:
nvidia-smi等命令响应慢,先查load average与 CPU 调度(top、ps -eLo pid,psr,pcpu,stat,comm | sort -k3 -nr | head),再怀疑驱动; - 应急止血:确认为驱动级故障时,
time nvidia-smi复测 + 查 Xid,避免盲目重启 GPU / 服务器扩大影响。