RHEL 7.4 服务器启动失败掉进 dracut emergency mode,根分区 XFS 损坏。在 emergency shell 里 xfs_repair 直接报 Device or resource busy;改用安装介质 Rescue 并 Skip to shell 后,设备虽未挂载但 dmsetup 显示 Open count = 1、lvchange -an 也停不掉 —— 存储探测仍在持有引用。最终在内核参数加 rd.break,抢在 switch_root 之前进入 dracut shell,lvscan → lvchange -ay 激活 root 后设备节点才出现(未激活时 xfs_repair 会误报 couldn't initialize XFS library),确认 /dev/mapper/rhel-root → dm-3 身份无误,先让内核回放 XFS 日志而非直接 -L,再执行 xfs_repair 完成修复。
本案例目录
RHEL 7 根文件系统 XFS 损坏无法启动 · rd.break 抢出离线修复环境
服务器:RHEL 7.4 · 排查日期:2026-09-20 说明:文中主机名、存储 WWID 等已脱敏,操作命令与输出均保留原文。
一、 故障背景
一台运行 Red Hat Enterprise Linux 7.4 的服务器异常启动失败,系统在启动过程中直接掉进 dracut emergency mode,无法进入正常的登录界面。
服务器系统盘采用 LVM + XFS 结构,逻辑卷分布如下:
| 逻辑卷 | 容量 | 文件系统 | 用途 |
|---|---|---|---|
/dev/rhel/root |
50 GiB | XFS | 系统根 / |
/dev/rhel/home |
30.49 TiB | XFS | 业务数据 |
/dev/rhel/swap |
4 GiB | swap | 交换分区 |
底层物理卷位于 /dev/sda3,整体存储关系为:
/dev/sda
 ├─ /dev/sda1
 ├─ /dev/sda2
 └─ /dev/sda3
       │
       └─ VG: rhel
           ├─ LV: root  50.00 GiB   →  /dev/mapper/rhel-root
           ├─ LV: home  30.49 TiB
           └─ LV: swap   4.00 GiB
⚠️ 一个必须提前说明的前提:这台服务器同时还挂着大容量数据存储,系统里存在 multipath 聚合出来的设备节点。也就是说
ls /dev/mapper/里会同时出现好几个「看起来都像文件系统」的设备。修复开始之前,必须先确认清楚哪个才是系统根分区——这一点在第九节会变成一个真实的险情。
二、 故障现象:进入 dracut emergency mode
服务器正常启动失败,屏幕上出现:
Generating "/run/initramfs/rdsosreport.txt"

Entering emergency mode. Exit the shell to continue.
Type "journalctl" to view system logs.
You might want to save "/run/initramfs/rdsosreport.txt" to a USB stick or /boot
after mounting them and attach it to a bug report.
这已经是内核在明确告知:根文件系统挂载失败了。
按最直觉的思路,第一反应是直接在 emergency shell 里对根文件系统做一次 XFS 修复:
xfs_repair /dev/mapper/rhel-root
结果被直接拒绝:
xfs_repair: cannot open /dev/mapper/rhel-root: Device or resource busy
设备节点明明存在,却处于 Busy 状态,无法执行离线修复。
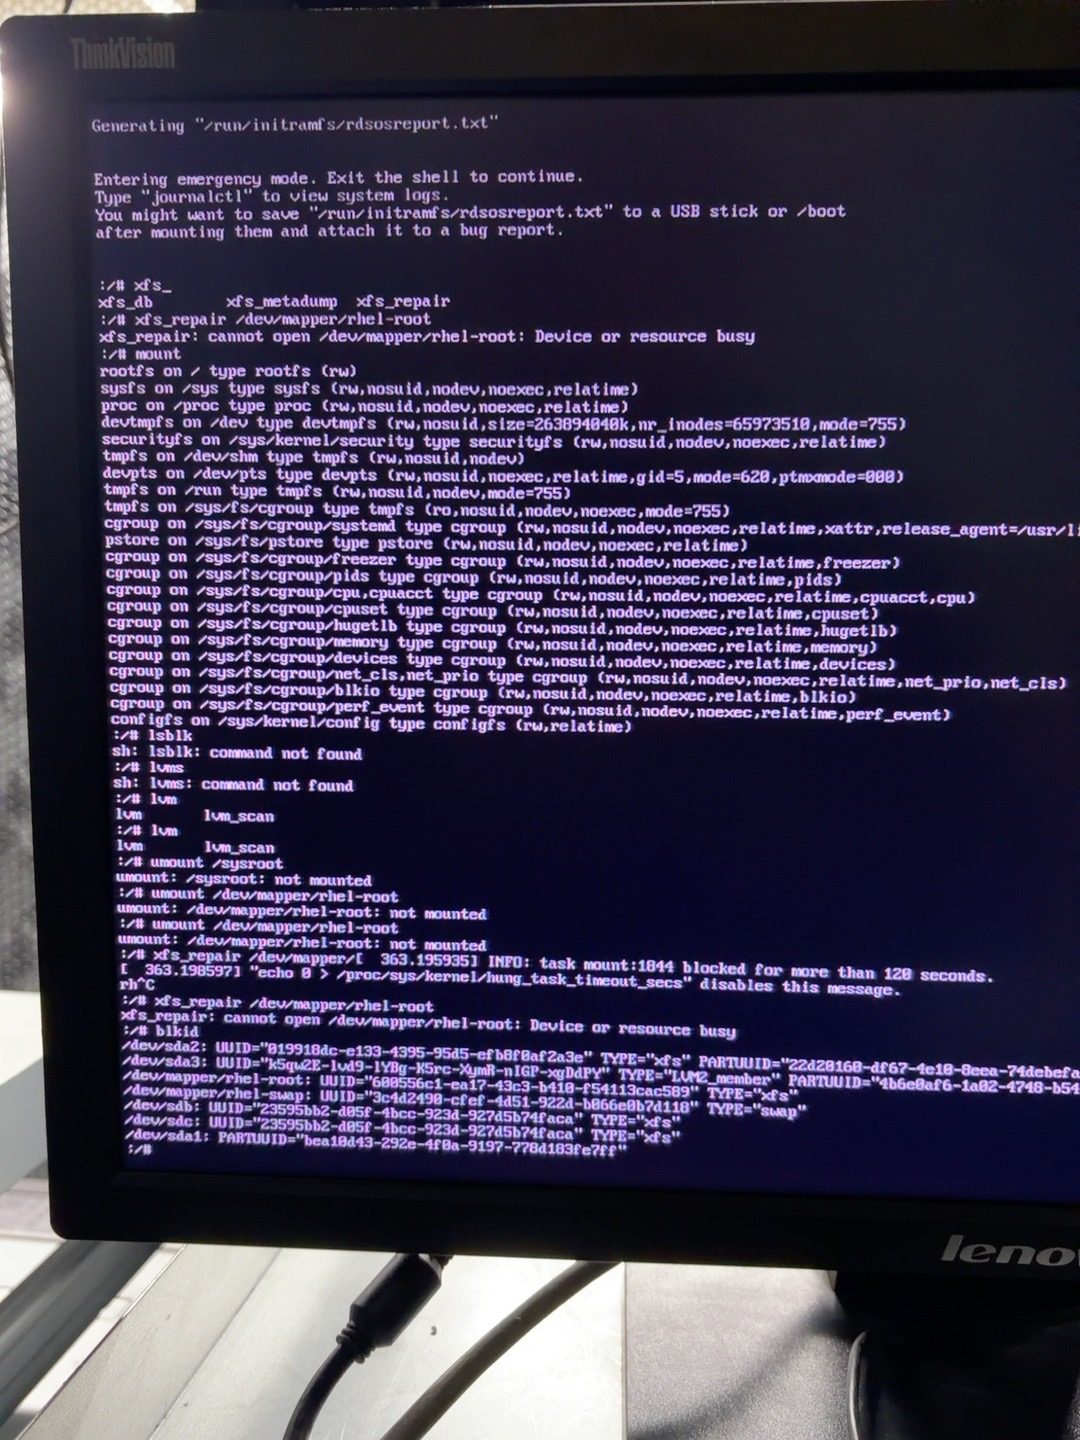
这就是本次排查的第一个核心卡点。
三、 为什么不能直接在 emergency mode 里修复
很多人会默认一个假设:
既然已经进了 emergency mode,系统等于没起来,那根文件系统应该是离线的,可以直接修。
这个假设是错的。
原因在于 initramfs 的启动流程。虽然完整的 Linux 用户态还没有起来,但根文件系统的相关设备已经被 initramfs 的启动流程打开并持有了引用——内核正在尝试用它完成 switch_root,或者已经把它纳入待切换的目标。
而 XFS 的修复铁律是:
xfs_repair必须在文件系统未挂载、且没有任何进程持有引用的前提下运行。
所以「进了 emergency mode」≠「根文件系统已经离线」。这是两个完全不同的概念。
四、 改用 RHEL 安装介质进入 Rescue 环境
既然原系统自己的 initramfs 拿不到干净环境,那就换一条路:用 RHEL 7.4 安装介质启动服务器,走 Rescue 模式。
启动菜单路径:
Troubleshooting
    ↓
Rescue a Red Hat Enterprise Linux system
Rescue 会给出四个选项:
1) Continue
2) Read-only mount
3) Skip to shell
4) Quit (Reboot)
这里选择:
3) Skip to shell
💡 为什么选 Skip to shell,而不是默认的 1) Continue? 选 Continue 时,Rescue 会自动把原系统挂载到
/mnt/sysimage下。而我们的目的恰恰是不要让原系统的根文件系统被挂载——一旦被挂载或持有引用,后面的xfs_repair就又会撞上Device or resource busy。Skip to shell 只给一个干净的 Anaconda shell。
进入 shell 后先看清楚磁盘拓扑:
lsblk
可以看到:
sda
├─sda1
├─sda2
└─sda3
   └─rhel-root    50G
再确认当前 Rescue 系统自己的根在哪:
live-rw     →  当前救援系统的 /
rhel-root   →  故障服务器原来的 /
这里 live-rw 是安装介质在内存里跑的临时根,跟故障盘没有任何关系,可以放心。
五、 异常:rhel-root 没挂载,却依然是 Busy
按理说跳过了自动挂载,rhel-root 应该是干净的。但实际检查下来并不乐观。
先看挂载状态:
mount | grep -E 'rhel|sysimage'
没有任何输出——rhel-root 确实没有被正常挂载。
但换一个角度查设备本身:
dmsetup info /dev/mapper/rhel-root
输出:
Name:              rhel-root
State:             ACTIVE
Read Ahead:        256
Tables present:    LIVE
Open count:        1
Major, minor:      253, 3
Number of targets: 1
注意这一行:
Open count: 1
内核认为这个 device-mapper 设备仍然被打开着一次。 没有挂载,却有人持有引用。
接下来是一轮「凶手排查」,把常见的持有者逐个排除:
# 1. 谁在用这个设备?
fuser -v /dev/mapper/rhel-root
# → 无输出

# 2. 有没有进程打开它?
lsof /dev/mapper/rhel-root
# → 没有找到普通进程

# 3. 有没有被别的 dm 设备作为底层?
ls -la /sys/class/block/dm-3/holders/
# → 空

# 4. 会不会被当成 swap 用了?
cat /proc/swaps
# → 没有 rhel-root

# 5. 那直接停用 LV 行不行?
lvchange -an /dev/rhel/root
# → 仍然提示文件系统正在使用,无法停用
五条线索全部落空,但 Open count 就是顽固地停在 1。
结论只能是:
Rescue / Anaconda 环境自身的存储探测机制(udev + LVM + storage probe)仍然持有着该设备的引用。
到这里其实有一条「看起来能解决」的路——直接强拆:
dmsetup remove -f /dev/mapper/rhel-root # ❌ 本次没有采用
这个命令风险很高。 remove -f 会强制摘掉 device-mapper 映射,底层引用关系一旦被破坏,轻则设备节点消失、LVM 元数据错乱,重则让本来还有救的文件系统更难恢复。在生产盘上,这条路不该走。
六、 关键一步:用 rd.break 抢出一个干净的 shell
绕了两圈之后,真正有效的办法其实非常轻量:在 Rescue 启动项的 kernel 参数里加 rd.break。
rd.break 的作用是让 dracut 在 switch_root 之前中断启动流程,抢在根切换之前把控制权交出来。
重新从安装介质启动,在内核参数末尾追加 rd.break,随后屏幕上出现:
Warning: Break before switch_root
Starting Dracut Emergency Shell...
进入:
switch_root:/#
这个环境比完整的 Anaconda Rescue 干净得多——系统还没有完成后续的 root 切换,存储探测也还没把设备接管过去,正好可以在最早的时间点处理 LVM 和 XFS。
💡 一个反直觉的坑:进入
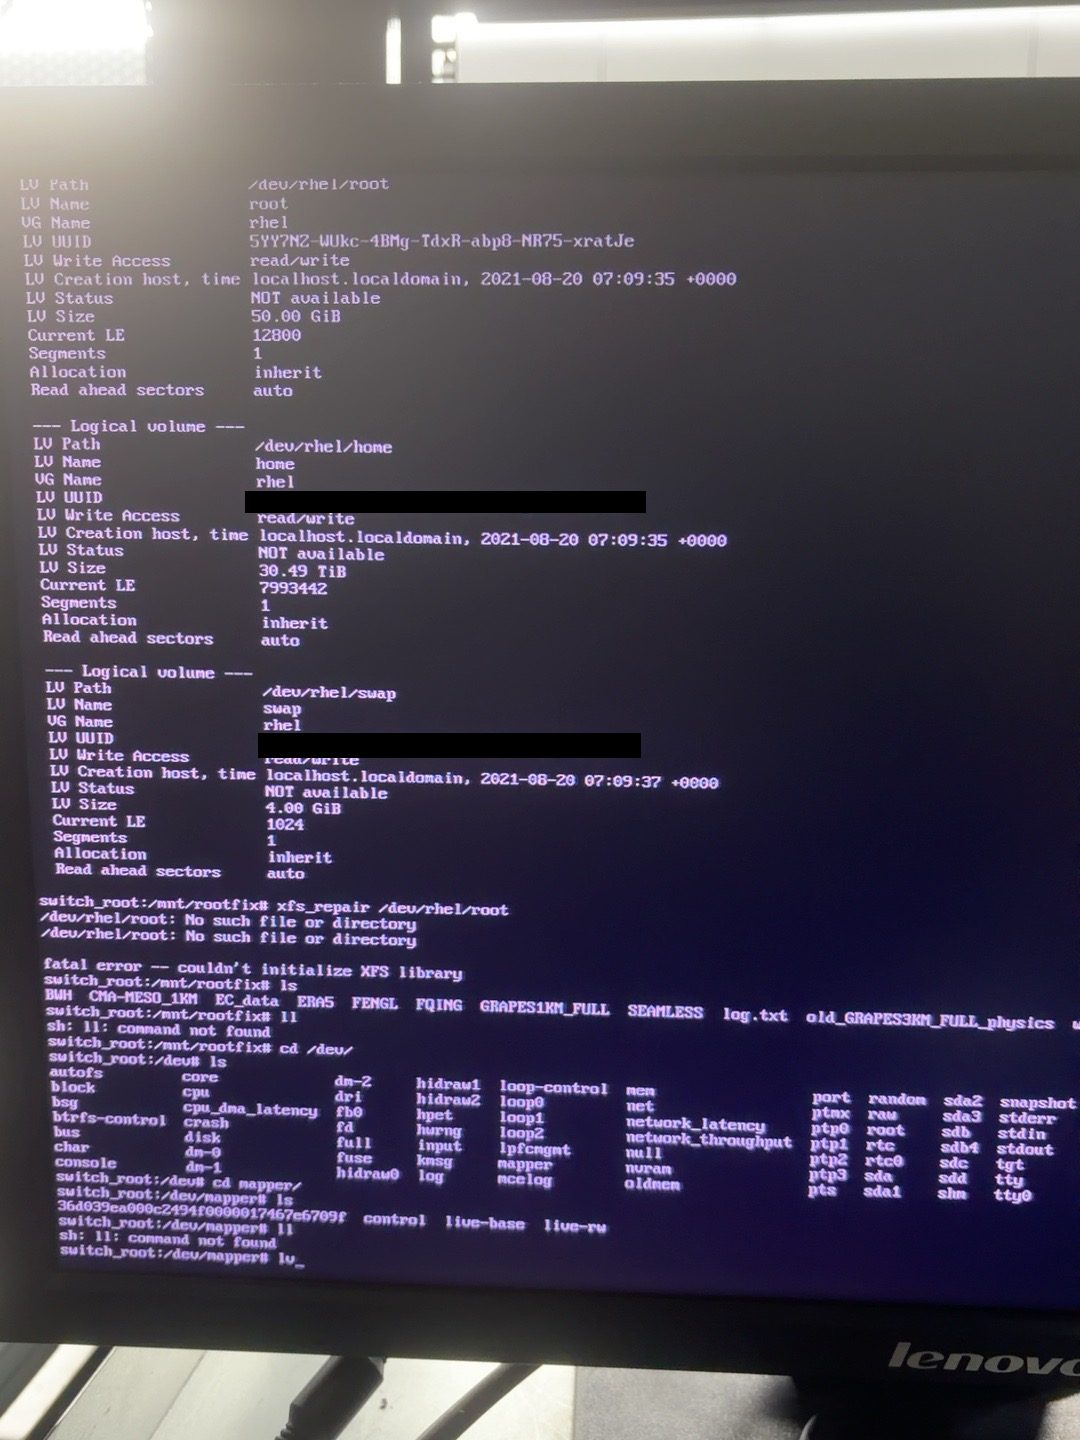
switch_root:/#之后,如果此时 LV 还处于未激活状态,/dev/rhel/root这个节点根本不存在。这时候执行xfs_repair /dev/rhel/root,报错并不是「设备忙」,而是一句很容易让人误判的话:
/dev/rhel/root: No such file or directory
fatal error -- couldn't initialize XFS library
看到
couldn't initialize XFS library,第一反应往往是「xfsprogs 坏了 / 库有问题」,实际根因只是设备节点还没被创建出来。先lvchange -ay激活,问题自然消失。
七、 重新识别并激活 LVM
在 switch_root shell 里,先扫描物理卷:
lvm pvscan
输出:
PV /dev/sda3 VG rhel lvm2 [<30.55 TiB / 0 free]
再扫描逻辑卷:
lvm lvscan
可以识别出三个 LV:
/dev/rhel/root    [50.00 GiB]
/dev/rhel/home    [30.49 TiB]
/dev/rhel/swap    [ 4.00 GiB]
但此时它们是 inactive 的。查看状态:
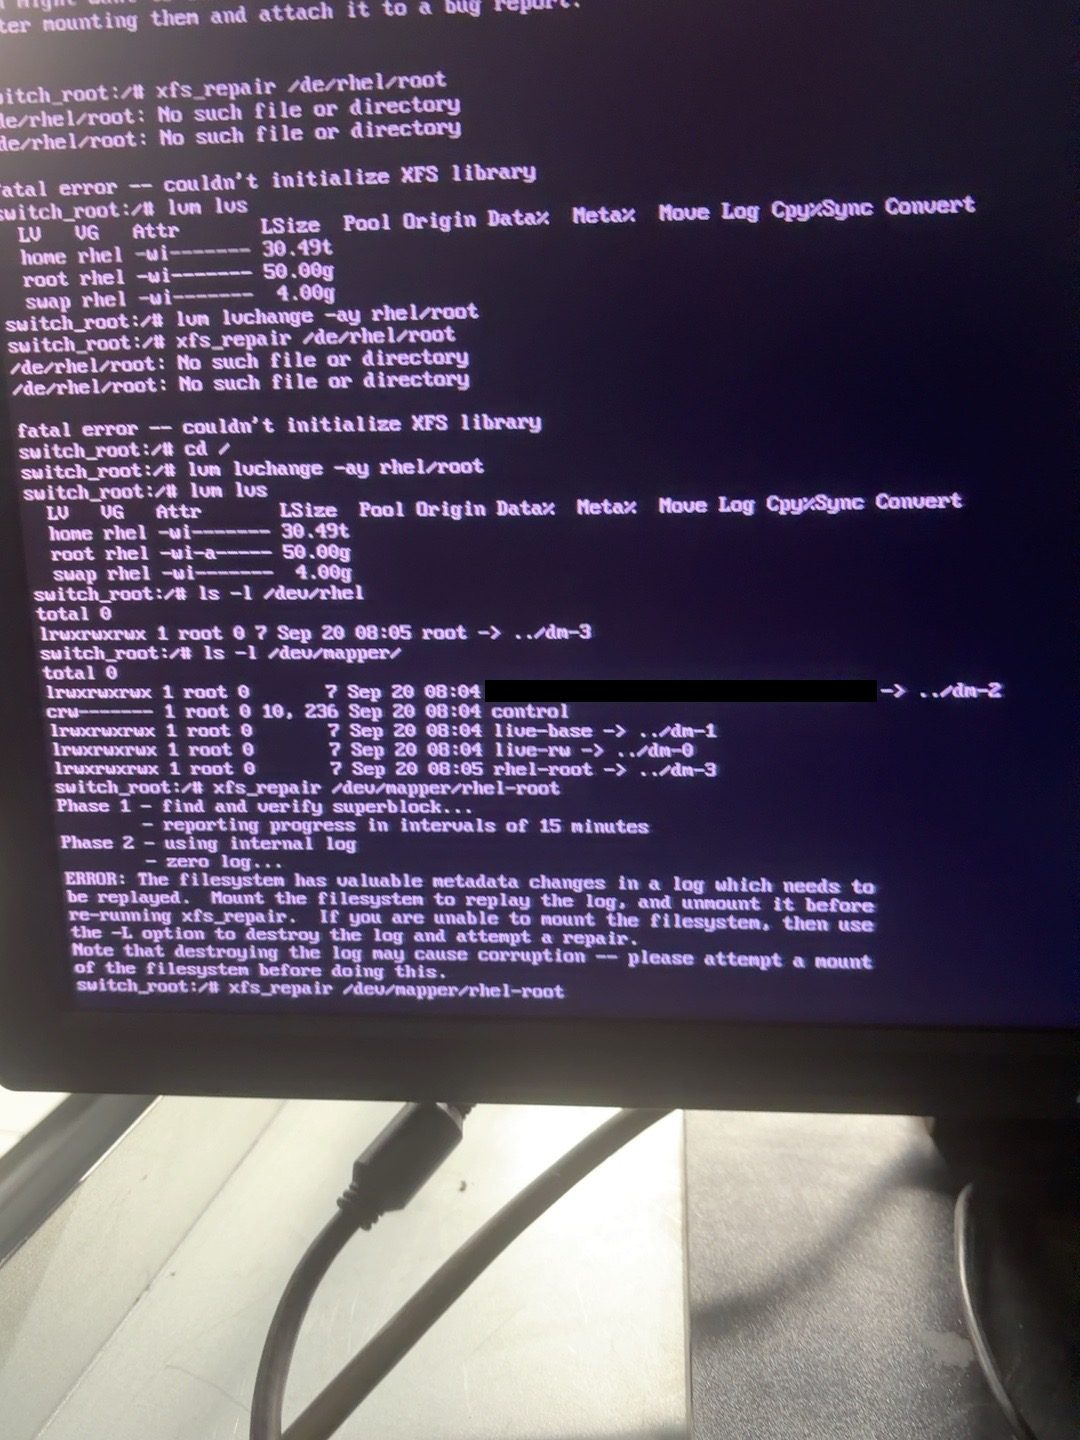
lvm lvs
  LV    VG    Attr       LSize
  home  rhel  -wi------- 30.49t
  root  rhel  -wi------- 50.00g
  swap  rhel  -wi-------  4.00g
注意 Attr 里的 -wi-------——中间的 a 位为空,表示未激活。只有激活后,/dev/rhel/* 和 /dev/mapper/* 下的设备节点才会被创建出来。
激活根逻辑卷:
lvm lvchange -ay rhel/root
再确认一次:
lvm lvs
  LV    VG    Attr       LSize
  home  rhel  -wi------- 30.49t
  root  rhel  -wi-a----- 50.00g   ← 已激活
  swap  rhel  -wi-------  4.00g
设备节点随之出现:
ls -l /dev/rhel
# root -> ../dm-3

ls -l /dev/mapper
# rhel-root -> ../dm-3
至此,真正的系统根逻辑卷才正式就位:
/dev/mapper/rhel-root → dm-3 → 50 GiB
八、 第一次 xfs_repair 被 XFS 日志拦下
设备身份确认无误后,执行修复:
xfs_repair /dev/mapper/rhel-root
开始一切正常,XFS 被正确识别:
Phase 1 - find and verify superblock...
Phase 2 - using internal log
        - zero log...
但随后报错中断:
ERROR: The filesystem has valuable metadata changes in a log
which needs to be replayed.

Mount the filesystem to replay the log, and unmount it before
re-running xfs_repair.

If you are unable to mount the filesystem, then use the -L
option to destroy the log and attempt a repair.

Note that destroying the log may cause corruption -- please attempt
a mount of the filesystem before doing this.
这段提示信息非常关键,它说明了 XFS journal / log 中还残留着尚未回放的元数据事务。
⚠️ 绝对不要一看到这个报错就条件反射地加上
-L。
-L的含义不是「更彻底的修复」,而是 销毁(zero)XFS 日志,然后继续修复。日志里那些已提交但还没落到数据区的元数据更新,会被直接丢弃。正确的优先级是: 1. 先尝试正常挂载文件系统,让 XFS 内核驱动自己完成日志回放(journal replay); 2. 回放完成后正常卸载; 3. 再运行
xfs_repair。只有在文件系统完全无法挂载、且没有其他选择的情况下,才考虑
-L作为最后手段。
(顺带一提,本站另一篇案例 XFS 元数据损坏(I/O Error)· xfs_repair 七阶段全流程抢救 里,/home 分区正是因为底层 I/O 错误导致挂载时直接抛错、陷入死循环,才被迫动用 -L。两篇对照着看,能更清楚地理解这个参数的适用边界。)
九、 一次「差点修错设备」的险情
本次故障排查中最值得记录的一个坑,发生在确认设备身份这一步。
服务器上挂着 multipath 聚合出来的大容量数据盘,在 /dev/mapper/ 下的名字形如:
/dev/mapper/36d039ea…e6709f (存储 WWID 已部分隐去)
一开始这个设备也能被 xfs_repair 正常识别——因为它本身也是 XFS 文件系统。于是很自然地产生了「它会不会就是 root」的怀疑,并对它执行了修复、然后挂载验证:
mount /dev/mapper/36d039ea…e6709f /mnt/rootfix
挂载成功,但 ls 出来的内容是这样的:
BWH
CMA-MESO_1KM
EC_data
ERA5
GRAPES1KM_FULL
wind_solar_obs
...
这不是 Linux 根目录。
一个正常的 Linux 根应该长这样:
bin  boot  dev  etc  home  lib  lib64  media
mnt  opt  proc  root  run  sbin  srv  sys  tmp  usr  var
于是立刻停止了对该设备的一切操作。
💡 这个经历说明一件事:不要因为一个设备是 XFS,就认为它是需要修复的 root。
尤其当服务器存在 SAN / iSCSI / FC / multipath / 大容量数据盘 时,
/dev/mapper/下会同时出现多个「长得像文件系统」的块设备,仅凭名字根本看不出谁是谁。动手之前,必须先把这条链路完整地确认一遍:
PV → VG → LV → device-mapper → dm-N本次真正的 root 最终确认路径为:
/dev/sda3
   ↓
VG rhel
   ↓
LV root  50 GiB
   ↓
/dev/rhel/root
   ↓
/dev/mapper/rhel-root
   ↓
/dev/dm-3
而那块数据盘对应的是
dm-22,跟 root 完全没有关系。
十、 正式执行 XFS 修复
确认目标设备无误、并完成日志处理后,最终针对真正的:
/dev/mapper/rhel-root
执行修复。过程中出现大量如下输出:
disconnected inode 123269141, moving to lost+found
disconnected inode 123269142, moving to lost+found
disconnected inode 123269143, moving to lost+found
...
这说明文件系统中存在大量已经失去目录连接关系的 inode——它们是文件系统结构损坏的直接证据。
xfs_repair 的处理方式是:把这些能被恢复、但无法确定原本属于哪个目录的对象,统统一并移动到:
/lost+found
随后进入收尾阶段:
Phase 7 - verify and correct link counts...
并进行链接计数修正:
resetting inode ... nlinks ...
最终输出:
verify and correct link counts - 16 of 16 allocation groups done
Format log to cycle ...
done
看到 done,意味着这次 xfs_repair 已经正常执行完成。
十一、 修复完成后的验证(重启前必做)
修复完成后,不要急着重启。先用一次挂载来确认成果——因为服务器上同时还有别的 XFS 设备,挂载前务必再核对一次设备路径。
创建临时挂载点:
mkdir -p /mnt/rootfix
挂载:
mount /dev/mapper/rhel-root /mnt/rootfix
检查根目录内容:
ls -lah /mnt/rootfix
正常情况下应该能看到完整的 Linux 系统目录结构:
boot etc home root usr var ...
由于本次修复过程中出现了大量 moving to lost+found,这一步还必须额外检查孤立文件:
ls -lah /mnt/rootfix/lost+found
确认无误后,正常卸载:
cd /
umount /mnt/rootfix
然后重启:
reboot -f
重启前记得移除安装介质,让服务器从系统盘启动。
十二、 本次故障中的六个关键经验
这次问题真正容易踩坑的地方,可以总结成下面几点:
1. Emergency mode ≠ 文件系统已经离线
根文件系统仍可能被 initramfs 的启动流程持有引用,因此 xfs_repair 会报 Device or resource busy。要修复根,就必须换一个不碰根的环境。
2. Rescue 模式同样可能占用设备
即使选择了 Skip to shell,Anaconda / udev / LVM / storage probe 依然可能导致 dmsetup info 显示 Open count: 1,lvchange -an 也无法停用。此时强拆 dmsetup remove -f 风险极高,不要走这条路。
3. rd.break 是处理根文件系统问题的利器
在 switch_root 之前中断启动,可以获得一个比完整 Rescue 干净得多的修复环境——这是本次真正解决问题的关键一步。
4. 不要轻易使用 xfs_repair -L
当出现 valuable metadata changes in a log 时,首选方案是挂载 → 让内核回放日志 → 卸载 → 再修复。只有文件系统完全无法挂载、且没有其他选择时,才考虑 -L。
5. 多磁盘 / multipath 环境必须先确认设备身份
本次服务器同时存在 96T 级数据设备。如果仅根据 /dev/mapper/* 的名字操作,很容易修错文件系统、甚至破坏本来完好的数据盘。动手前一定走一遍 PV → VG → LV → dm-N 的映射确认。
6. 看到 done 不代表所有文件都回到了原位
大量 disconnected inode ... moving to lost+found 说明文件系统结构已经发生过明显损坏。xfs_repair 修复的是文件系统一致性,它无法保证所有孤立文件恢复成原来的路径和文件名。
十三、 最终修复流程总结
本次真正有效的处理路径可以浓缩为:
RHEL 无法启动
      ↓
dracut emergency mode
      ↓
xfs_repair /dev/mapper/rhel-root
      ↓
❌ Device or resource busy
      ↓
改用安装介质 Rescue(Skip to shell)
      ↓
❌ 仍未挂载,但 Open count = 1
      ↓
重新启动 + 内核参数加 rd.break
      ↓
进入 switch_root 之前的 dracut shell
      ↓
lvm pvscan / lvscan
      ↓
lvm lvchange -ay rhel/root        ← 激活后设备节点才出现
      ↓
确认 /dev/mapper/rhel-root → dm-3 → 50 GiB
      ↓
处理 XFS journal(先尝试挂载回放)
      ↓
xfs_repair /dev/mapper/rhel-root
      ↓
修复 inode / AG / link count
      ↓
孤立 inode → lost+found
      ↓
Phase 7 完成 → done
      ↓
挂载验证 → 卸载
      ↓
重启系统
结语
这次故障真正困难的地方,从来不是 xfs_repair 这条命令本身,而是两件事:
- 如何获得一个真正离线的根文件系统——从 emergency mode 到 Anaconda Rescue 再到
rd.break,本质都是在为这一件事寻找出路; - 如何在复杂存储环境中确认正确的修复对象——设备身份认错一次,后果可能比不修更严重。
如果只记住三条:
第一,XFS repair 前一定确认文件系统离线。 第二,
-L不要作为第一选择。 第三,多磁盘 / LVM / multipath 环境一定先确认设备映射,再动手。
最后,尤其对生产服务器而言:文件系统修复之前,如果条件允许,应优先做好块设备快照、镜像或其他可恢复备份。 xfs_repair 能恢复文件系统结构的一致性,但它并不是数据恢复工具。